このサイトは、お客様へのサービス向上などの用途でCookieを使用しております。
詳細はこちらをご参照ください。

  1. HOME
  2. Technology
  3. VLMオーケストレーション技術

Morpho VLM Fluid Action

VLMオーケストレーション技術

主な利用シーン

  • スマートシティ
  • 建設
  • 自動運転・車載
  • 監視カメラ
  • 船・電車・航空機
  • 自律走行車

主な機能・目的

  • 物体検出
  • 人影検出
  • 画像認識

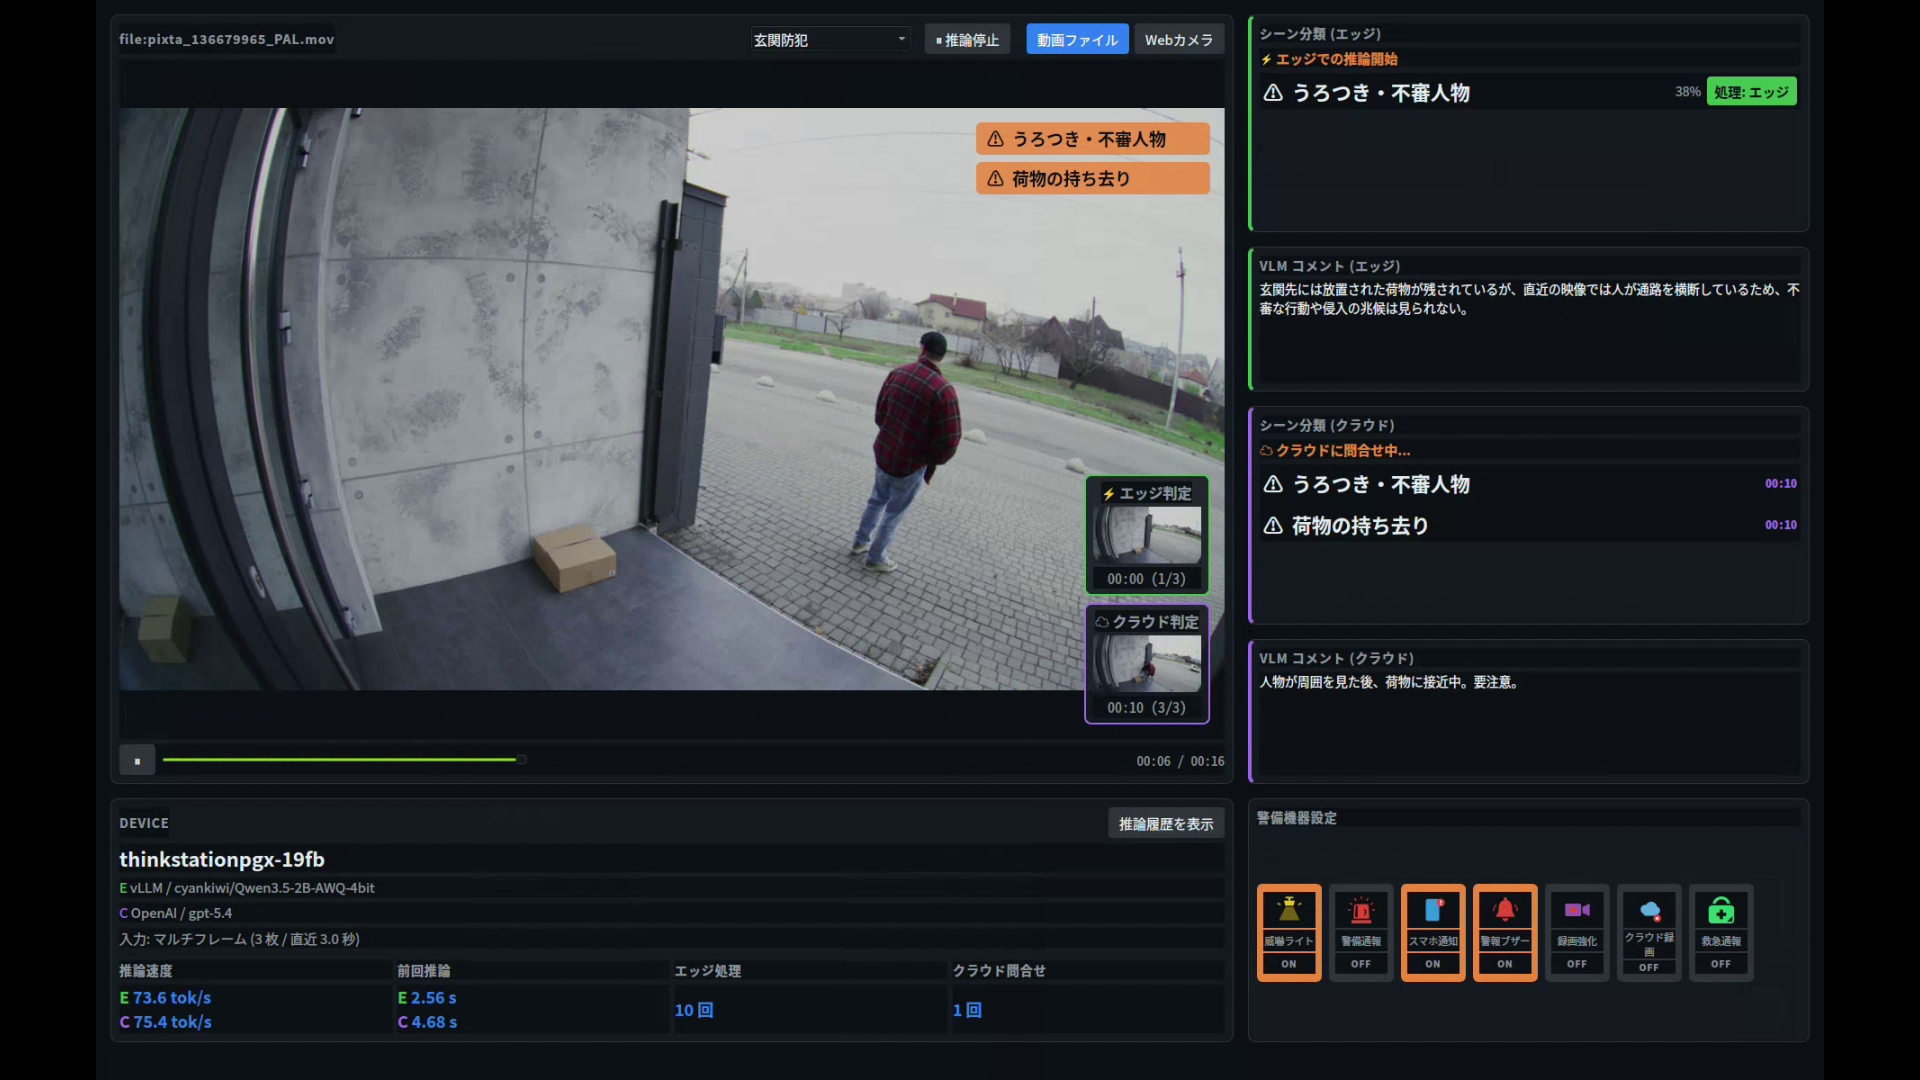
Morpho VLM Fluid Action™は、エッジ上で動作する軽量なVision Language Model(VLM)とクラウド上のVLMを連携させ、学習データを用意することなく映像から状況を判断するソフトウェアです。認識したい対象と、認識した際に実施する動作を設定ファイルに記述するだけで利用できます。

Point

  • 設定ファイルを書くだけで、認識対象と認識後の動作を規定できる:VLMを利用する際に課題となるプロンプトの設計や出力の扱いを製品側で吸収し、「何を認識するか」「認識した結果として何をするか」の記述のみで高度な認識を組み込めます。
  • エッジ推論の確信度に応じて、クラウドへ自動でエスカレーションする:エッジ側の推論の確信度が一定以下の場合に、判断をクラウドの大規模なモデルへ自動的に委ねます。エッジでの利用と限界の見極めを製品側で行うため、利用者が振り分けを設計する必要がありません。
  • 学習データの収集が難しいシーンにも適用できる:発生頻度が低い事象や、対象の種類を事前に列挙できない事象など、学習データを揃えることが難しい場面でも認識を実現します。

詳細

玄関先防犯シナリオでの適用例

提供形態

Morpho VLM Fluid Action™は、エッジ端末上で動作するソフトウェアと、クラウド上のVLMを連携させて動作します。
エッジ側は、動作環境に合わせたアプリケーション開発用のライブラリファイルおよび技術ドキュメント等をご提供します。
クラウド側の構成を含む提供形態については、お問い合わせください。

Webinar

画像処理やAI技術の基礎や活用のポイントなどを紹介するWebinarを開催しています。
以下より、これまでに開催したWebinarを視聴できます。